Model Llama 3 8B v kvantizaci Q4_K_M zabere na disku přibližně 4,9 GB. Qwen2.5 14B ve stejné kvantizaci kolem 9 GB. Pokud se tyto soubory nevejdou do VRAM nebo do systémové RAM, začne se výkon lámat na offloadu a marketingové TOPS jsou rázem bezcenné.
U lokálního běhu modelů 7B–14B rozhoduje šest věcí: velikost VRAM, kapacita a propustnost RAM, chlazení, příkon, podpora NPU a SSD. TOPS v datasheetu je jen hrubý strop pro výpočet. Generování tokenů je totiž většinou vázané na propustnost paměti, ne na špičkový počet operací. Jinak řečeno: model se při každém tokenu musí celý přečíst z paměti.
1. VRAM: 8 GB, 12 GB, nebo 16 GB
Pro 7B až 8B model ve Q4 stačí 8 GB VRAM, ale jen s malou rezervou. Na 14B Q4 je 8 GB málo: část vrstev se přesune do systémové RAM a rychlost výrazně klesne. 12 GB VRAM zvládne 14B Q4, ale kontext ukusuje další paměť. U Llama 3 8B zabere KV cache při 8k kontextu v FP16 zhruba 1 GB, při 32k kolem 4 GB. Proto je 16 GB VRAM bezpečná volba pro 14B a delší kontext. Integrovaná grafika si navíc bere systémovou RAM, takže „16 GB VRAM“ u iGPU není totéž jako 16 GB na dedikované kartě.
Propustnost paměti je konkrétnější údaj než TOPS. RTX 4060 Laptop s 8 GB GDDR6 má 128bitovou sběrnici a propustnost kolem 272 GB/s. RTX 4090 Laptop s 16 GB má 256bitovou sběrnici a kolem 576 GB/s. U 4,5GB modelu to dělá teoretický strop přibližně 60 vs. 128 tokenů za sekundu; reálné hodnoty jsou nižší kvůli režii. Zpracování dlouhého promptu je naopak výpočetně náročné, tam se vyšší TOPS projeví.
2. Systémová RAM: 16 GB je minimum, 32 GB rozumná rezerva
Windows, prohlížeč a nástroje pro běh modelu potřebují několik GB. U 7B modelu na CPU se 16 GB dá použít, ale není prostor na dlouhý kontext ani více aplikací. Pro 14B model na CPU nebo pro offload vrstev z GPU je 32 GB praktické minimum. Důležitá je i dvoukanálová konfigurace: jednostranná RAM snižuje propustnost a u iGPU to bolí dvojnásob. Pokud notebook sdílí paměť s integrovanou grafikou, musíte počítat s tím, že BIOS nebo ovladač část RAM grafice vyhradí.
3. Chlazení: rozhoduje trvalý výkon, ne první minuta
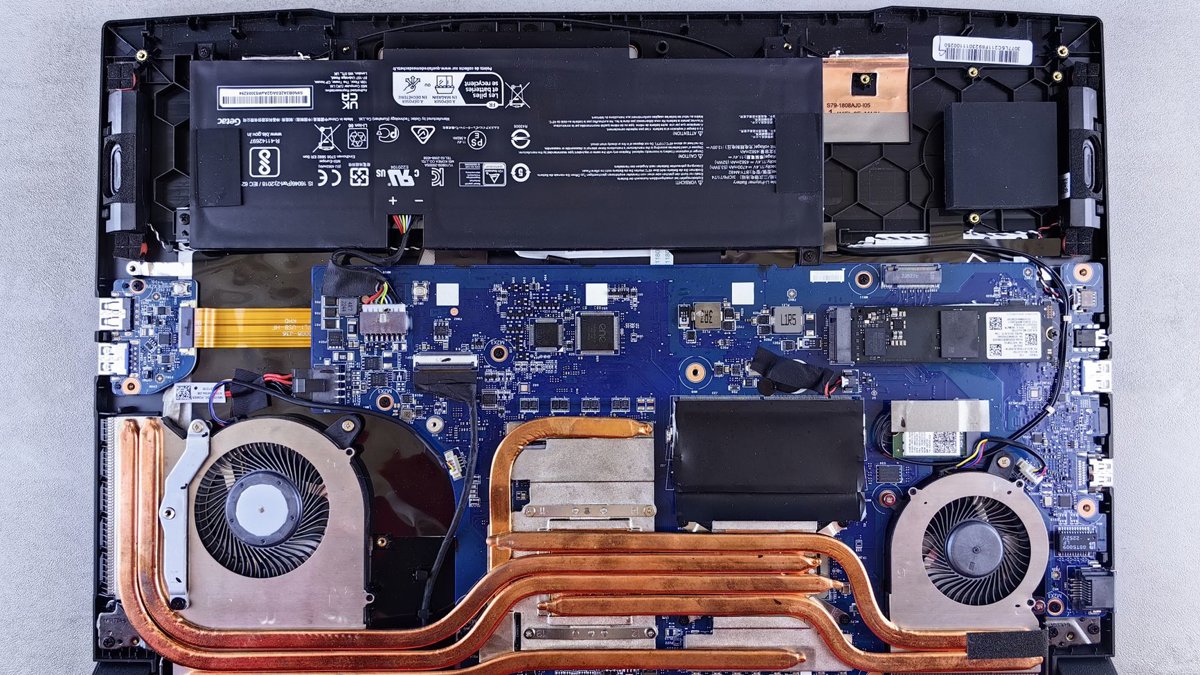
LLM inference běží klidně desítky minut v kuse. Tenký notebook s krátkodobým boostem může být první minutu rychlý a pak spadnout. U recenzí proto hledejte měření po 10–15 minutách zátěže, ne jednorázový benchmark. Dva ventilátory, vapor chamber a dostatečně otevřené větrací otvory mají větší cenu než papírově vyšší TGP, které stejně rychle zthrottluje. Notebook s 8 GB VRAM a dobrým chlazením může být v trvalém běhu příjemnější než 12GB stroj, který po pěti minutách ztratí třetinu výkonu.
4. Příkon: na baterii to nebude stejné
Většina notebooků na baterii snižuje takt GPU, někdy dedikovanou grafiku úplně vypne. Pro seriózní běh 7B–14B modelu počítejte s tím, že stroj musí být zapojený v síti. Podívejte se na wattáž napájecího adaptéru a na to, zda výrobce uvádí trvalý TGP, ne jen maximální boost. Vyšší příkon ale není automaticky lepší: novější 100W GPU může být efektivnější než starší 140W karta. U přenosného stroje je kompromis jasný – delší běh na baterii znamená menší model nebo cloud.
5. NPU: 40 TOPS samo o sobě nic neřeší
Copilot+ PC vyžaduje NPU s 40+ TOPS. To je údaj pro akceleraci určitých operací v INT8, ne záruka, že na NPU poběží 14B model rychleji než na GPU. Podpora NPU v nástrojích jako llama.cpp, Ollama nebo LM Studio závisí na konkrétním backendu, ovladači a převedeném modelu a často bývá experimentální. NPU se hodí spíš pro malé modely a always-on úlohy. Pro 7B–14B se dnes spolehlivě opíráte o dedikovanou GPU, případně o CPU s dostatkem rychlé RAM.
6. SSD: kapacita a stabilní čtení
Jeden model ve Q4 má 5–10 GB. Několik kvantizací, chatovací aplikace a další modely snadno zaberou 50–100 GB. Notebook pro lokální AI by měl mít 1 TB NVMe SSD, ideálně PCIe 4.0 s DRAM cache. PCIe 4.0 SSD čte 5–7 GB/s, PCIe 3.0 kolem 3–3,5 GB/s. Devítigigabajtový model se z PCIe 4.0 načte za necelé 2 sekundy, z PCIe 3.0 za 3–4 sekundy. Pokud se model nevejde do RAM, pomůže mmap ze SSD, ale start a přepínání modelů budou pomalejší. Levné QLC disky bez DRAM cache mohou být při delším zápisu a plnění cache znatelně horší.
Kdy je lepší externí GPU nebo cloud
Jakmile model s kontextem přeroste VRAM o více než 1–2 GB, začne být offload znát. eGPU s 16 GB VRAM přes Thunderbolt 4 nebo USB4 je rozumná cesta, pokud chcete zůstat u stejného notebooku. Počítejte ale s externím zdrojem, hlučností a horší přenositelností. Cloud dává smysl pro občasné použití, větší než 14B modely, dlouhý kontext nebo dávkové úlohy. Data při něm ale opouštějí počítač. Pro každodenní práci s citlivými dokumenty je výhodnější desktop nebo eGPU; pro jednorázové experimenty je cloud levnější než kupovat 24GB grafiku.
Praktická minima
7B–8B Q4: 8 GB VRAM, nebo 16 GB systémové RAM při běhu na CPU. 14B Q4: 12 GB VRAM, ideálně 16 GB, a 32 GB RAM. Delší kontext: 16+ GB VRAM a rezerva v RAM. Pokud to notebook nesplňuje, external GPU nebo cloud není porážka, ale racionální volba. TOPS porovnávejte až po těchto šesti parametrech.
Foto: Andrey Matveev / Pexels