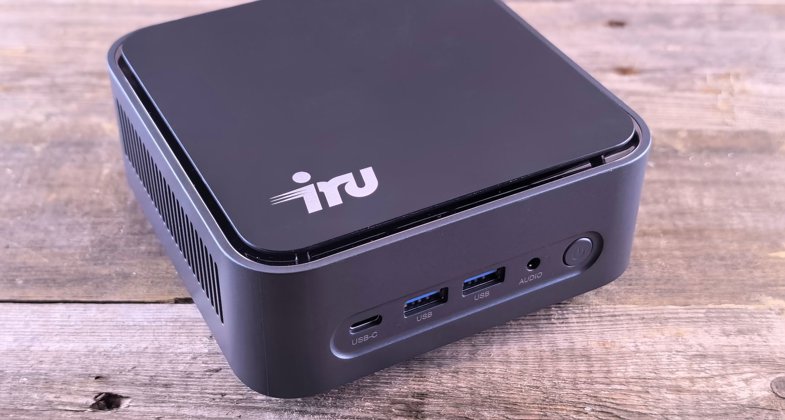
Tokeny za sekundu u lokálního modelu neurčuje výkon CPU ani počet TOPS v NPU, ale paměťová propustnost. Při generování každého tokenu se totiž musí přečíst váhy všech aktivních parametrů – u hustého modelu prakticky celý model. Mini-PC s dvoukanálovou DDR5-5600 dává 89,6 GB/s, takže u Llama 3.1 8B v kvantizaci Q4_K_M (zhruba 4,9 GB) je teoretický strop 18 tokenů za sekundu a reálně se dostanete na 10–14 tok/s. Výběr stroje pro lokální AI je tím pádem hlavně počítání: kolik bajtů se na jeden token přečte a jakou propustnost paměti má daný kandidát.
Nejrychlejší mini-PC současnosti pro tento účel je AMD Ryzen AI Max+ 395 (Strix Halo). Má 256bitovou sběrnici LPDDR5X-8000, tedy 256 GB/s, a až 128 GB paměti, z nichž lze velkou část přidělit integrovanému Radeonu 8060S – ten nemá vlastní VRAM a sahá do systémové RAM. Vejde se do něj gpt-oss-120b v MXFP4 (asi 63 GB) i Llama 3.3 70B v Q4 (asi 40 GB). U 70B je strop 256/40 = 6,4 tok/s, reálně 4–5 tok/s. Výchozí TDP čipu je 55 W a konfigurovatelný strop 120 W, takže se do stowattové zásuvky vejde i s rezervou na desku a disky.
Kolik paměti model potřebuje
Orientační pravidlo pro kvantizaci Q4_K_M je 0,6–0,7 GB na miliardu parametrů. Llama 3.1 8B zabere 4,9 GB, 14B asi 9 GB, Mistral Small 3.2 (24B) 14 GB, Qwen2.5-Coder-32B nebo Gemma 3 27B zhruba 17–20 GB, Llama 3.3 70B kolem 40 GB a gpt-oss-120b v MXFP4 asi 63 GB.
K tomu se připočítá KV cache, která roste lineárně s délkou kontextu. U 8B modelu s 32 tisíci tokeny kontextu zabere ve fp16 kolem 4 GB, s KV cache v Q8_0 polovinu. U 70B modelu se stejnou délkou kontextu jde o více než 10 GB – proto se u velkých modelů vyplatí flash attention a kvantovaná cache.
Zvláštní kategorii tvoří MoE modely. Qwen3-30B-A3B má sice 30 miliard parametrů (v Q4 asi 18 GB), ale na každý token se čtou jen 3 miliardy aktivních. Na stroji s 89,6 GB/s je tak teoreticky 50 tok/s místo 5. Podobně gpt-oss-120b aktivuje kolem 5 miliard parametrů. Pro mini-PC jsou MoE modely nejlepší kompromis mezi velikostí a rychlostí.
Tři třídy mini-PC
Mini-PC s SO-DIMM DDR5: stroj s Ryzen 7 8845HS nebo Core Ultra 7 155H, dvoukanál DDR5-5600 = 89,6 GB/s, až 96 GB RAM (2× 48GB modul). Paměť se dá dokoupit, cena je nejnižší. Na 14B model stačí, 32B v Q4 dá kolem 4 tok/s, 70B pod 2 tok/s.
Pájena LPDDR5X: Ryzen AI 9 HX 370 má 128bitovou sběrnici LPDDR5X-7500 = 120 GB/s, ale většina mini-PC končí na 32 GB. Intel Core Ultra 200V (Lunar Lake) má 136 GB/s a NPU 4 se 48 TOPS, jenže paměť je v pouzdře a 32 GB je maximum. To je tvrdý strop: 32B model v Q4 zabere 20 GB a na KV cache, systém a prohlížeč zbývá 12 GB.
Unified memory se širokou sběrnicí: Strix Halo (256 GB/s, 128 GB) a Apple M4 Pro v Mac mini (273 GB/s, 64 GB). Apple má výhodu zralého softwaru přes MLX, AMD zase dostupnost 128GB konfigurací a Vulkan bez dodatečné instalace.
NPU: 50 TOPS generování nezrychlí
XDNA 2 v Ryzen AI 300 zvládá 50 TOPS v INT8, NPU 4 v Lunar Lake 48 TOPS. Ollama ani llama.cpp ale NPU nepoužívají – sáhnou po CPU nebo GPU přes Vulkan, CUDA, ROCm či Metal. NPU se dá využít přes FastFlowLM (AMD) nebo OpenVINO GenAI (Intel), a to hlavně u malých modelů a při zpracování promptu, protože NPU sahá do stejné paměti jako zbytek čipu a na generování tokenů narazí na stejný propustnostní strop. Kupovat mini-PC kvůli vysokému číslu TOPS nemá smysl.
Co nastavit, aby to jelo
Na Linuxu je potřeba zvednout limity GTT, jinak jádro integrované grafice nedovolí alokovat velký model – používají se parametry amdgpu.gttsize a ttm.pages_limit. Na Windows stačí v ovladači Adrenalin nastavit Variable Graphics Memory. V llama.cpp se vyplatí Vulkan backend: funguje bez instalace ovladačů navíc a na Strix Halo je srovnatelný s ROCm, jehož podpora pro čip gfx1151 dorazila až v průběhu roku 2025. Dále je vhodné zapnout flash attention a KV cache v Q8_0. Modely zabírají desítky GB, takže NVMe disk pod 2 TB nemá smysl.
Kdy je levnější cloud
Provoz na 100 W znamená 0,1 kWh za hodinu, při zhruba 6 Kč/kWh tedy 0,60 Kč za hodinu plné zátěže. Při 20 tok/s to je 72 000 tokenů za hodinu, tedy přibližně 8 Kč za milion výstupních tokenů. Cloudové ceny za milion výstupních tokenů (kurz 22 Kč/USD): GPT-4o mini 0,60 USD, tedy asi 13 Kč; DeepSeek V3 1,10 USD, tedy 24 Kč; Claude Sonnet 15 USD, tedy 330 Kč.
Proti nejlevnějším API je lokální provoz zhruba stejně drahý, proti špičkovým modelům řádově levnější. Jenže hardware se musí zaplatit: u stroje za 50 000 Kč je při úspoře 322 Kč na milion tokenů proti Sonnetu návratnost po asi 155 milionech tokenů, proti GPT-4o mini by to bylo přes deset miliard tokenů, tedy v praxi nikdy. Lokální běh se vyplatí tam, kde data nesmějí odejít (kapitola V GDPR řeší i předání do USA), kde je potřeba offline provoz, nebo kde se drahé modely používají ve velkém objemu. Fine-tuning a trénink zůstávají doménou CUDA.
Rozhodující číslo při nákupu je poměr propustnosti paměti k velikosti modelu: 89,6 GB/s u DDR5-5600, 256 GB/s u Strix Halo, 273 GB/s u M4 Pro. Nejlepší kompromis pro mini-PC jsou MoE modely – Qwen3-30B-A3B má 30 miliard parametrů, ale na token se čtou jen 3 miliardy, takže se vejde do 32GB konfigurace a rozjede se i na stroji s 90 GB/s.
Foto: Andrey Matveev / Pexels