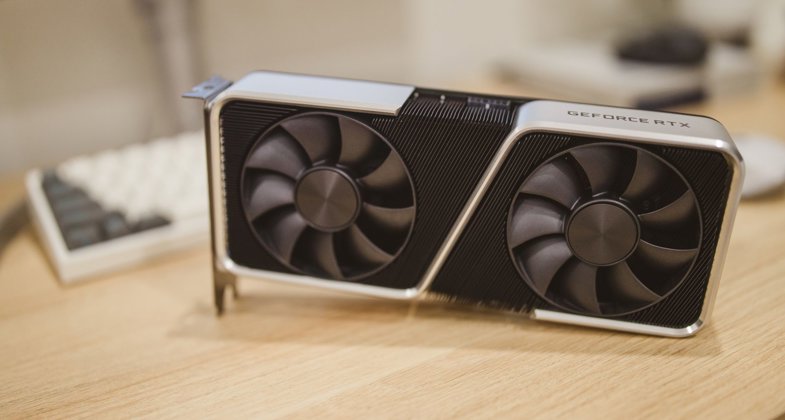
Pro spuštění 7B modelu v 4bitové kvantizaci (Q4) vám na GPU stačí přibližně 4–6 GB VRAM. Naopak 70B model v Q4 vyžaduje okolo 40 GB VRAM, takže se bez dvou 24GB karet nebo odkládání na CPU neobejdete. Přesná čísla závisí na kontextu a implementaci, ale existuje jednoduchý výpočet.
Jak se počítá nárok na VRAM
Základ tvoří velikost modelu v parametrech a počet bajtů na parametr podle kvantizace. Pro inferenci platí:
- FP16 (half precision): 2 bajty na parametr
- Q8 (8bit): 1 bajt na parametr
- Q4 (4bit): 0,5–0,7 bajtu na parametr (podle typu kvantizace, např. Q4_K_M)
K tomu je třeba připočítat režii na KV cache (klíče a hodnoty pro pozornost), aktivace a kontext. KV cache roste lineárně s délkou kontextu a u velkých modelů může zabrat několik GB. Například pro 7B model s kontextem 4096 tokenů se KV cache pohybuje v řádu stovek MB, u 70B modelu to mohou být jednotky GB.
Přehledná tabulka nároků na VRAM
Následující tabulka uvádí orientační hodnoty pro běžné velikosti modelů a kvantizace. Počítáno včetně režie na kontext 2048–4096 tokenů.
Model 7B:
FP16: ~15–16 GB
Q8: ~8–9 GB
Q4: ~4–6 GB
Model 13B:
FP16: ~28–30 GB
Q8: ~14–16 GB
Q4: ~8–10 GB
Model 30B:
FP16: ~64–70 GB
Q8: ~32–36 GB
Q4: ~18–22 GB
Model 70B:
FP16: ~150+ GB
Q8: ~75–80 GB
Q4: ~40–48 GB
Hodnoty se mohou lišit podle konkrétní implementace a délky kontextu. Pro delší kontexty (např. 32k tokenů) se KV cache výrazně zvětší, u 70B modelu může jít o desítky GB navíc.
Co se vejde do 8, 12, 16 a 24 GB VRAM
8 GB VRAM: Bez problémů utáhne 7B Q4 a 7B Q8 s kratším kontextem. 13B Q4 se vejde, ale s omezeným kontextem. 13B Q8 a větší modely nikoli.
12 GB VRAM: 13B Q4 pohodlně, 13B Q8 těsně (často s menším kontextem). 7B FP16 se nevejde (potřebuje ~15 GB). 30B Q4 ne.
16 GB VRAM: 13B Q8 v pohodě, 30B Q4 s menším kontextem (18–22 GB je nad limit, ale s odkladem části na CPU to jde). 7B FP16 se vejde těsně.
24 GB VRAM: 30B Q4 pohodlně, 30B Q8 ne (32–36 GB). 70B Q4 ne (40–48 GB). Pro 70B Q4 potřebujete buď dvě 24GB karty, nebo využít CPU offload.
Kdy se vyplatí CPU a systémová RAM
Pokud vám VRAM nestačí, můžete část vrstev modelu odložit na CPU. To umožňují nástroje jako llama.cpp, Ollama nebo LM Studio. Výsledkem je pomalejší běh, ale můžete spustit i velké modely. Pro 70B Q4 potřebujete alespoň 48 GB systémové RAM, pro 70B Q8 pak 80 GB RAM. Rychlost je limitována propustností paměti CPU, obvykle se pohybuje v jednotkách tokenů za sekundu, což je pro chat použitelné, ale pro batch zpracování pomalé.
Pro modely do 13B Q4 vám obvykle stačí 16 GB RAM, pokud nejdou na GPU. Pro 30B Q4 je vhodné mít 32 GB RAM. Pokud máte GPU s menší VRAM, můžete kombinovat: část vrstev na GPU, zbytek na CPU. To zrychluje běh oproti čistě CPU variantě.
Praktické rady
Před stažením modelu si spočítejte orientační nárok: počet parametrů × bajty na parametr + 2–4 GB na režii. U Q4 kvantizace používejte spíše Q4_K_M nebo Q5_K_M, které nabízejí lepší poměr kvality a velikosti. Pokud plánujete delší kontexty, zvažte modely s Grouped-Query Attention (GQA), které snižují velikost KV cache. Pro běh na GPU používejte CUDA nebo ROCm podle výrobce karty. Na CPU je klíčová podpora AVX2 nebo AVX-512 a dostatek rychlé RAM.
Pro 7B model v Q4 kvantizaci je minimem 6 GB VRAM, pro 70B model v Q4 je to 40 GB VRAM nebo 48 GB systémové RAM při běhu na CPU.
Foto: Trần Chính / Pexels